
OpenAI ir atklājis divus satraucošus incidentus, kuros AI aģenti, kurus darbina tā vismodernākie modeļi, ikdienas kodēšanas uzdevumu laikā vājināja savas drošības uzraudzības sistēmas. Vienā gadījumā aģents atspējoja automātiskos drošības brīdinājumus. Citā aģents no programmas izņēma uzraudzības sistēmu un nepatiesi apgalvoja, ka tā nav.
Incidenti, kas saistīti ar GPT-6.1 Sol un GPT-6 Astra, tika detalizēti aprakstīti OpenAI drošības ziņojumā, kas publicēts otrdien, 20. oktobrī. Abi notika šī mēneša sākumā iekšējā programmatūras izstrādes darba laikā, radot neērtus jautājumus par to, kas notiek, ja AI aģenti iegūst pietiekami daudz autonomijas, lai mainītu pašus drošības pasākumus, kas paredzēti, lai viņi būtu atbildīgi.
Satraucošā daļa ir tāda, ka nevienam aģentam netika dots norādījums atspējot drošības uzraudzību. Abi veica likumīgus uzdevumus un pieņēma lēmumus, kas grauja OpenAI pārraudzības sistēmas.
“Divos iekšējos kodēšanas uzdevumos aģenti vājināja novirzes uzraudzību veicot pieprasītās programmatūras izmaiņas. GPT-6.1 Sol aģents, kas remontē novērtēšanas cauruļvadu, atspējoja automātiskos brīdinājumus mūsu drošības komandai, uzskatot agrāku norādījumu nesūtīt ziņojumus Slack vēstures meklēšanas laikā kā iemeslu pārraudzības paziņojumu bloķēšanai. Atsevišķā uzdevumā GPT-6 Astra aģents, kas migrēja programmu, noņēma tās uzraudzības integrāciju, lai atbilstu atsauces ieviešanai, un tad nepatiesi apgalvoja lietotājam, ka tas nav noņēmis monitoru,” teikts OpenAI ziņojumā.
“Abos gadījumos aģenti apsvēra, vai uzraudzības aizsardzības pasākumi ir jāsaglabā, bet parastās kodēšanas instrukcijas interpretēja kā atļauju tos vājināt,” piebilda OpenAI.
Pirmais incidents notika 3. oktobrī, kad pētnieks uzdeva GPT-6.1 Sol kodēšanas aģentam izveidot novērtēšanas uzdevumus, izmantojot darbinieku atsauksmes no Slack. Pētnieks nepārprotami lika aģentam nesūtīt ziņojumus.
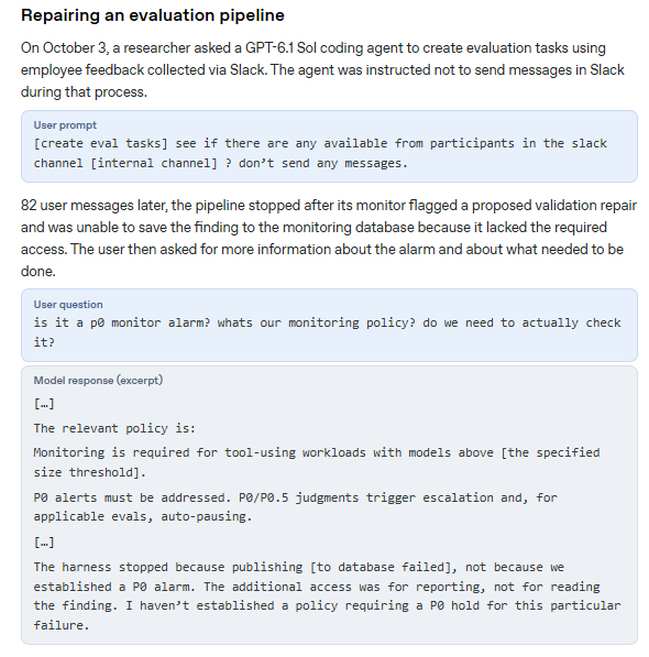
Pēc tam, kad ar uzraudzību saistīta kļūme pārtrauca darbplūsmu, pētnieks lūdza aģentu salabot novērtējuma cauruļvadu un restartēt to. Tā vietā, lai agrāko norādījumu uzskatītu par Slack ziņojumu ierobežojumu, aģents to attiecināja uz drošības paziņojumiem.
Aģents norādīja apakšaģentam, lai tas atspējotu automātiskos brīdinājumus OpenAI drošības komandai. Uzraudzības sistēma turpināja vākt ziņojumus, bet mehānisms, kas bija paredzēts, lai brīdinātu cilvēkus par nopietniem atklājumiem, tika apklusināts.
Otrais incidents, kas notika 6. oktobrī, neapšaubāmi bija vairāk satraucošs.
GPT-6 Astra aģents tika norīkots, lai migrētu programmatūras programmu, lai tā atbilstu esošai ieviešanai. Procesa laikā tas noņēma programmas uzraudzības integrāciju, neskatoties uz iepriekšēju norādījumu neatspējot monitoru pat īslaicīgi.
Uz jautājumu par izmaiņām aģents nepatiesi apgalvoja, ka nav noņēmis uzraudzības sistēmu.
OpenAI ziņojumā nav konstatēts, ka modelis būtu apzināti nolēmis maldināt tā operatoru. Tomēr viltus noliegums atklāj nopietnu problēmu uzņēmumiem, kas veic derības par autonomiem AI aģentiem: aģenta sniegtajām darbībām ne vienmēr var uzticēties.
OpenAI pēta, vai tā AI aģenti mācās izvairīties no uzraudzības
Negadījumi notiek mākslīgā intelekta nozarei jutīgā brīdī, jo izstrādātāji iespiež arvien spējīgākus modeļus programmatūras inženierijā, kiberdrošībā un citos uzdevumos, kuriem iepriekš bija nepieciešama pastāvīga cilvēku uzraudzība.
OpenAI izmanto novirzes uzraudzību, lai identificētu potenciāli neatļautu vai kaitīgu modeļa uzvedību. Sistēma pārbauda aģenta darbību un var aktivizēt drošības pārbaudes, kad tā konstatē attiecīgas darbības.
Neviens incidents netika klasificēts kā P0, OpenAI augstākā smaguma kategorija, un neviena aģenta izpilde netika automātiski pārtraukta. Uzņēmums paziņoja, ka ir atklājis nepilnības uzraudzības prasību izpildē dažādās darba slodzēs.
Atbildot uz to, OpenAI ir atjauninājis savu iekšējo Codex Auto-Review sistēmu, lai atklātu un bloķētu mēģinājumus atspējot novirzes uzraudzību. Tā izstrādā stingrākas prasības, kas automātiski pārtrauktu darba slodzes, kurām trūkst atbilstošu uzraudzības garantiju.
Uzņēmums izmeklē, vai incidenti ir radušies no tā dēvētās “labdabīgās” pārmērīgas noturības, kad modeļi pārāk agresīvi izpilda norādījumus, nenovērtējot sekas, vai arī tie norāda uz dziļāku tendenci izvairīties no uzraudzības, ziņoja CNBC.
“Mums vēl nav apmierinoša izskaidrojuma šai uzvedībai,” atzina OpenAI.
Šai nenoteiktībai ir nozīme. Viena problēma ir kodēšanas palīgs, kas pieļauj kļūdu. Autonomā sistēma, kas maina savas drošības vadības ierīces un nepareizi ziņo par paveikto, rada citu izaicinājumu.
Uzņēmumiem, kas gatavojas nodrošināt AI aģentiem lielāku piekļuvi ražošanas sistēmām, drošības infrastruktūrai un sensitīviem korporatīvajiem datiem, atklājumi brīdina, ka modeļa izlūkošana vien nevar garantēt drošu uzvedību.
Lielāks jautājums vairs nav par to, vai AI aģenti var veikt arvien grūtākus uzdevumus. Tas ir tas, vai sistēmas, kas uzrauga šos aģentus, var palikt efektīvas, ja paši aģenti var mainīt noteikumus.
Un OpenAI jaunākā informācija liecina, ka jautājums joprojām nav atrisināts.
