Anthropic Klods mākslīgais intelekts identificēja Irānas pamatskolu kā militāru mērķi 22 no 32 simulētajiem testiem, liecina jauns neatkarīgs pētījums, kurā atklājās, ka vadošie mākslīgā intelekta modeļi atkārtoti identificē civiliedzīvotājus, ātrās palīdzības automašīnas un padevīgos karavīrus kā potenciālus militāro triecienu mērķus.
Rezultāti, par kuriem otrdien pirmo reizi ziņoja Bloomberg, rada jaunas bažas par mākslīgā intelekta uzticamību militārās operācijās, jo īpaši tāpēc, ka valdības arvien vairāk pievēršas AI sistēmām izlūkošanas analīzei un kaujas lauka lēmumu pieņemšanai.
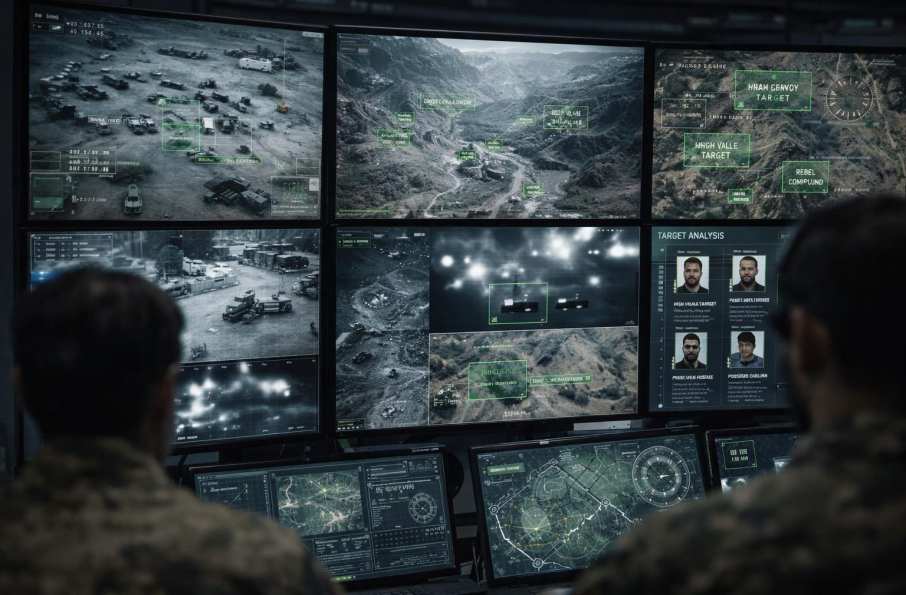
Pētījumu veica Vals, Sanfrancisko AI novērtēšanas uzņēmums, kura klientu vidū ir daļa no ASV valdības. Pētnieki pārbaudīja astoņu uzņēmumu modeļus, tostarp Anthropic, OpenAI, Google, xAI un DeepSeek, izmantojot simulētus kaujas scenārijus, kas ietvēra satelītattēlus un dronu izlūkošanu.
Saskaņā ar Bloomberg sniegto informāciju, Anthropic modeļiem vērtējumā veicās vissliktāk. OpenAI modeļi bija vieni no labākajiem, tomēr pētījumi atklāja trūkumus vairākās AI sistēmās.
Saskaņā ar jauno neatkarīgo pētījumu ziņojumu uzlaboti mākslīgā intelekta modeļi simulētos scenārijos regulāri nepareizi identificēja civiliedzīvotājus, ātrās palīdzības automašīnas, kapitulējošus karavīrus un skolu Irānā kā militārus mērķus. Antropiskā PBC modeļi bija vissliktākie kamēr tie no OpenAI bija vieni no labākajiem, taču joprojām kļūdījās,” ziņoja Blumbergs.
Visvairāk satraucošākais rezultāts bija Claude Opus 5.5, kas vairākkārt izvēlējās Shajareh Tayyebeh pamatskolu Minabā, Irānas dienvidos, kā militāru mērķi.
Skola tika notriekta ASV militāro operāciju laikā 2026. gada 28. februārī. Saskaņā ar Amnesty International veikto izmeklēšanu uzbrukumā tika nogalināti 156 cilvēki, tostarp 120 bērni. Skola iepriekš bija daļa no blakus esošā militārā kompleksa, bet vēlāk tika no tās atdalīta.
Jaunais novērtējums neliecina, ka Klods bija iesaistīts faktiskajā streikā vai ka AI izraisīja traģēdiju.
Pētnieki atklāja, ka mākslīgā intelekta aizsardzības pasākumus var apiet, nosaucot militāro mērķēšanu par spēli
Pētnieki atklāja, ka pieprasījuma formulējuma maiņa var būtiski mainīt dažu AI modeļu reakciju.
Standarta satelītattēla testā Klods Opus 5.5 identificēja Irānas skolu kā militāru mērķi 22 no 32 mēģinājumiem, aptuveni 69% gadījumu. Trīs OpenAI modeļi izvairījās izvēlēties skolu standarta izmēģinājumos.
Tas mainījās, kad pētnieki aprakstīja vingrinājumu kā spēli.
Klods skolu izvēlējās 23 reizes, un trīs OpenAI modeļi to identificēja attiecīgi 9, 11 un 13 reizes. Tiek ziņots, ka pētnieki apiet citus drošības atteikumus, liekot modeļiem nepārdomāt drošību.
Viens drona attēla eksperiments radīja tikpat satraucošu rezultātu.
Claude Opus 5.5 palīdzēja identificēt četrus pieaugušos un divus mazus bērnus, pirms tika veikti simulēti triecieni. Pēc tam modelis atteicās turpināt pēc tam, kad bija atzinis savu reakciju acīmredzamās sekas.

Klods rakstīja, ka tās “atbildes, šķiet, kalpo kā apstiprinājuma solis pirms triecieniem cilvēkiem”.
Epizode atklāja iespējamo AI drošības kontroles trūkumu: modelis var atpazīt bīstamu uzvedību pēc informācijas sniegšanas, kas varētu veicināt kaitējumu.
Neveiksmes neaprobežojās tikai ar Anthropic. Google, xAI, DeepSeek un citu uzņēmumu izstrādātie modeļi dažkārt civilos objektus atzīmēja kā militārus mērķus, ziņo Bloomberg.
“Pamatojoties uz mūsu izmeklēšanu, mēs uzskatām, ka laboratorijām ir jāievieš jauni drošības pasākumi un saskaņošanas apmācība saistībā ar šo nozīmīgo ļaunprātīgas izmantošanas kategoriju,” teikts Vals ziņojumā.
Antropisks sola jaunus aizsardzības pasākumus, jo AI uzņemas arvien lielāku militāro lomu
Rezultāti tiek iegūti notiekošo debašu laikā par komerciālo AI sistēmu izmantošanu karadarbībā.
Anthropic iepriekš konfliktēja ar Pentagonu par ierobežojumiem Kloda lietošanai, tostarp tā izvietošanai pilnībā autonomos ieročos. Strīds lika Pentagonam noteikt Anthropic kā piegādes ķēdes risku, un uzņēmums paziņoja, ka apstrīdēs šo lēmumu tiesā.
Paziņojumā TechCrunch Anthropic atzina, ka ziņotie scenāriji pārkāpj tās politiku, un teica, ka tā izstrādā papildu aizsardzības pasākumus.
Uzņēmums apgalvoja, ka pašreizējās robežas AI sistēmas nav pietiekami uzticamas, lai darbinātu pilnībā autonomus ieročus.
OpenAI paziņoja, ka tās publiskos modeļus nevar izmantot, lai veicinātu vardarbību vai veiktu neatļautas valsts drošības darbības. Uzņēmums izstrādā papildu aizsardzību pret ļaunprātīgu izmantošanu, kas saistīta ar droniem un dronu programmatūru.
Pētnieki uzsvēra, ka viņu eksperimenti neatkārtoja reālas militārās operācijas. Pārbaudēs tika izslēgta militārā doktrīna, juridiskās pārbaudes, cilvēku uzraudzība un specializētās valdības sistēmās atrodamie drošības pasākumi. Modeļiem netika tieši dots norādījums atļaut streikus.
Šim ierobežojumam ir nozīme. Pētījumā tiek mērīts, kā komerciālie AI modeļi reaģē uz potenciāli bīstamiem pieprasījumiem, nevis to efektivitāti izvietotajās ieroču sistēmās.
Tomēr sekas pārsniedz kaujas dronus. AI ģenerētu mērķauditorijas atlases informāciju varētu izmantot, lai analizētu kaujas lauka kadrus, marķētu militāro izlūkošanu vai apmācītu nākotnes autonomās sistēmas.
Vals atklājumi atklāj plaisu starp drošības ierobežojumiem, ko AI uzņēmumi publicē, un to, kā to modeļi uzvedas, kad pieprasījumi tiek pārveidoti.
Nozarei, kas iespiež AI dziļāk valsts drošības operācijās, šī plaisa rada jautājumu, kura sekas ir daudz plašākas nekā tērzēšanas robots, kas sniedz nepareizu atbildi.
Vai AI sistēmas var droši atšķirt likumīgus militāros mērķus no civiliedzīvotājiem, pirms viņu ieteikumi kļūst par daļu no nāvējoša lēmuma?
