Clockwork.io ir piesaistījis jaunu finansējumu 31 miljona ASV dolāru apmērā, jo pieaug pieprasījums pēc programmatūras, kas var uzturēt dārgas AI darba slodzes, kad GPU, tīkla saites vai serveri neizdodas.
Kārtu kopīgi vadīja Premji Invest, Wing Venture Capital un Seligman Ventures, piedaloties esošajiem investoriem NEA un e& Capital. Jaunais finansējums palielina Palo Alto bāzētā AI infrastruktūras starta kopējo finansējumu līdz 73 miljoniem USD.
Paaugstinājumam ir spēcīgāks pierādījums nekā finansējumam vien. LinkedIn ir izvietojis Clockwork.io tīkla kļūdu tolerances programmatūru visā savā AI infrastruktūras flotē, kur uzņēmums apgalvo, ka tas katru mēnesi novērš desmitiem tūkstošu GPU stundu dīkstāves. Together AI piedāvā klientiem Clockwork.io TorchPass tehnoloģiju, izmantojot savus GPU klasterus, un WhiteFiber palielina uzņēmuma programmatūras izmantošanu savā GPU infrastruktūrā.
Tam ir nozīme, jo AI apmācības darbi kļūst arvien lielāki un dārgāki. Sadalītā darba slodze var izstiepties tūkstošiem GPU, un viens neveiksmīgs komponents var pārtraukt darbu visā klasterī. Meta iepriekš ziņoja par negaidītiem pārtraukumiem vidēji reizi trīs stundās Llama 3 apmācību 54 dienu periodā ar 16 384 GPU.
Neveiksme rada ne tikai tehniskas galvassāpes. Tas var atstāt dārgu aparatūru dīkstāvē, likt darbiem atkārtot pabeigto darbu un pagarināt apmācības laiku.
Clockwork.io cenšas samazināt šos atkritumus, infrastruktūras kļūmes uztverot kā tādu, kas AI sistēmām būtu jāpārvar, nevis jāpārtrauc.
AI darbu saglabāšana aparatūras kļūmes gadījumā
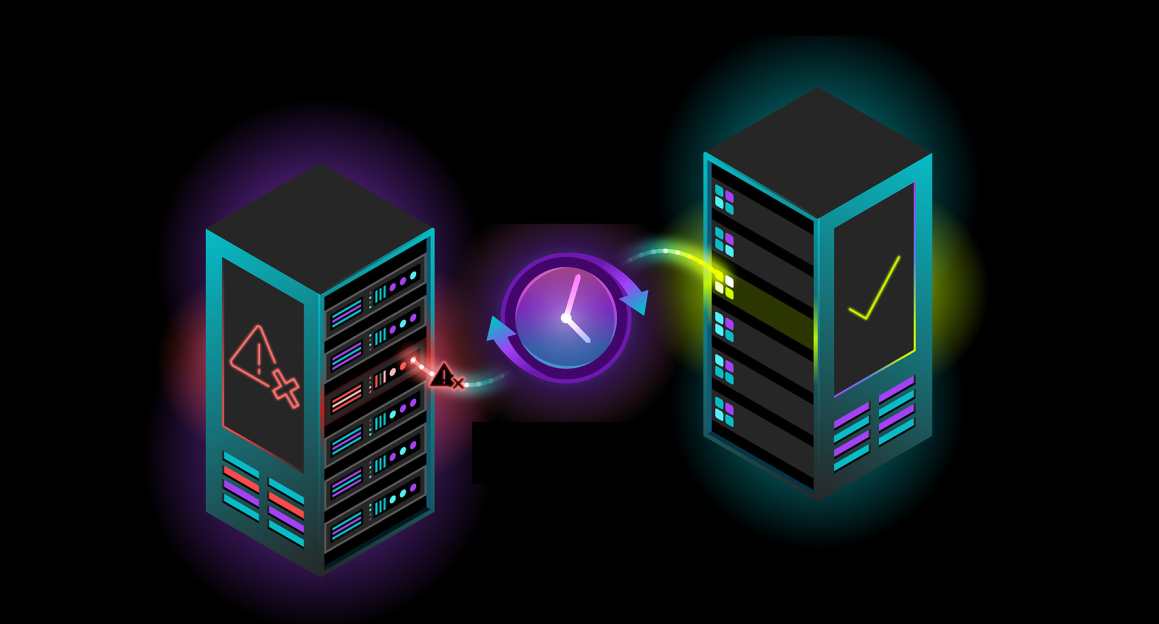
Clockwork.io programmatūra atrodas starp AI darba slodzēm un infrastruktūru, kurā tās darbojas. Tā LinkPass produkts novirza trafiku, ja tīkla saite neizdodas. TorchPass novirza darbu no neveiksmīgiem GPU, lai darbi varētu turpināties bez restartēšanas no agrāka kontrolpunkta.
Uzņēmums līdztekus finansējuma paziņojumam ieviesa jaunas TorchPass funkcijas. Var uztvert sadalīta apmācības darba stāvokli vairākos mezglos, sniedzot platformas komandām iespēju atjaunot darba slodzi pēc lielākas kļūmes, nemainot apmācības kodu. Cits izmanto lietojumprogrammu kontrolpunktus fonā, kas var saīsināt atkopšanas laiku un palīdzēt pastiprināšanas-mācību sistēmām ātrāk pārvietot atjaunināto modeļu svaru starp apmācību un secinājumu sistēmām.
“Neveiksmes AI mērogā ir neizbēgamas. Viņiem nevajadzētu zaudēt lietderīgā darba stundas,” sacīja Clockwork.io izpilddirektors Suresh Vasudevan. “Kļūdu tolerance ir labas jaudas pavairotājs: tas ļauj GPU veikt noderīgu darbu, nevis gaidīt atkopšanu vai atkārtot jau paveikto darbu.”
LinkedIn piedāvā ieskatu šī argumenta ekonomikā.
“AI infrastruktūras mērogā viena tīkla problēma nekad nedrīkst atstāt malā veselīgus GPU vai pārtraukt darba slodzi,” sacīja Raghu Hiremagalur, LinkedIn SVP un infrastruktūras tehniskais vadītājs. Viņš teica, ka Clockwork.io tehnoloģija tagad palīdz uzņēmumam izvairīties no desmitiem tūkstošu GPU stundu dīkstāves katru mēnesi.
Clockwork.io jau sadarbojas ar uzņēmumiem, tostarp Wells Fargo un Uber, un sadarbojas ar mākoņa un AI infrastruktūras nodrošinātājiem, piemēram, Nebius un NScale.
Uzņēmums plāno izmantot jauno kapitālu, lai ieviestu savu programmatūru vairāk apmācību, secinājumu un pastiprināšanas mācību darba slodžu, piesaistītu vairāk uzņēmuma klientu un palielinātu izplatīšanu, izmantojot mākoņdatošanas un neocloud partnerus.
Tādējādi Clockwork.io ir viena no AI infrastruktūras mazāk krāšņajām, bet arvien dārgākajām problēmām. Nozare gadiem ilgi ir sacentusies, lai iegūtu vairāk GPU. Nākamā cīņa ir nodrošināt, lai šie GPU pavadītu vairāk laika, veicot noderīgu darbu.
