
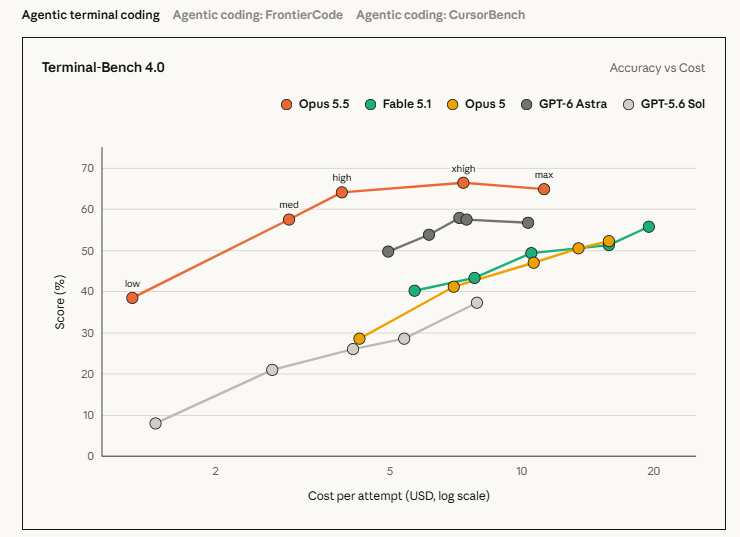
Anthropic otrdien laida klajā Claude Opus 5.5, panākot vēl vienu OpenAI pavērsienu ar jaunu vadošo AI modeli, kas, pēc uzņēmuma domām, var pārspēt GPT-5.6 Sol programmatūras izstrādes etalonā par aptuveni vienu trešdaļu izmaksām.
Jaunajam modelim ir vēl viens liels pārdošanas punkts: Anthropic saka, ka parastās darba slodzes izmaksas ir par aptuveni 40% mazākas nekā Opus 5. Tam ir nozīme mākslīgā intelekta tirgū, kurā modeļu veiktspēja turpina pieaugt, taču izmaksas, kas rodas, ieviešot pārrobežu modeļus lielos uzņēmumos, joprojām ir galvenais ierobežojums.
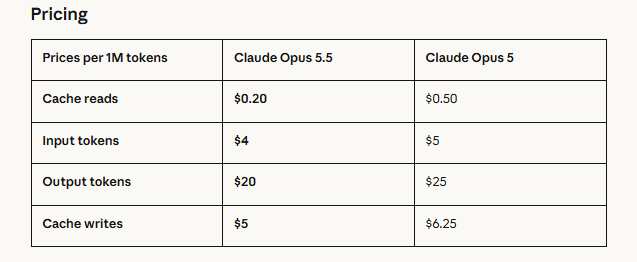
Opus 5.5 cena ir USD 4 par miljonu ievades marķieru un USD 20 par miljonu izvades marķieru, kas ir par 20% zemāka par Opus 5. Kešatmiņas nolasīšana maksā USD 0,20 par miljonu marķieru, kas ir par 60% samazinājums. Anthropic saka, ka modelis ģenerē jaudu par vairāk nekā 30% ātrāk nekā tā priekšgājējs.
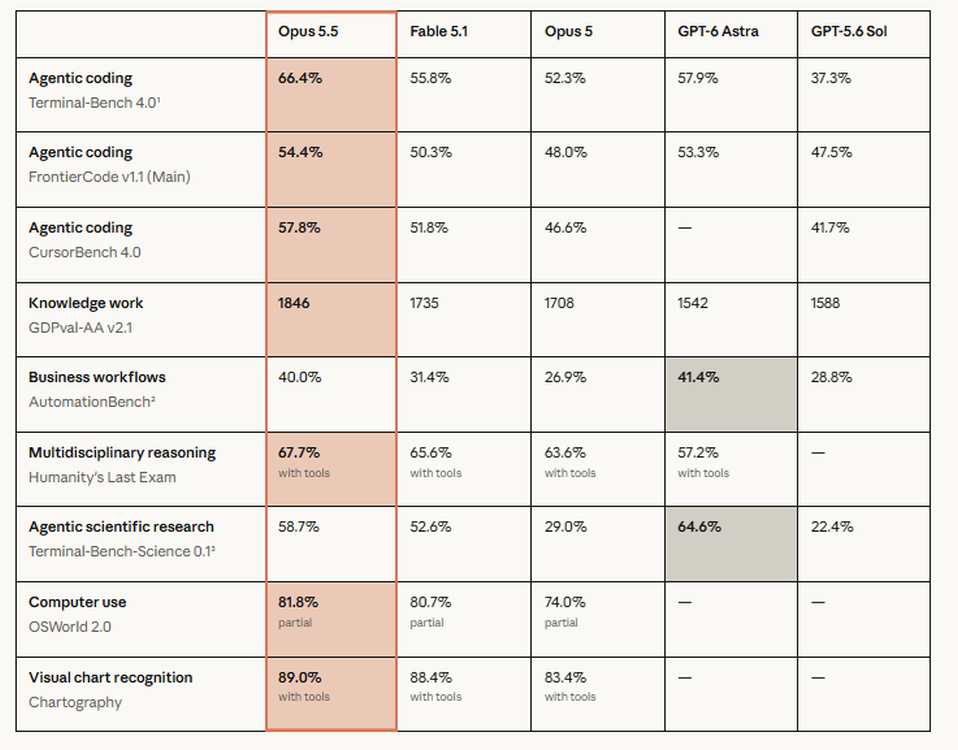
Uzņēmums Opus 5.5 pozicionē kā savu jauno vadošo modeli, kura veiktspēja ir salīdzināma ar tā augstākā līmeņa Claude Fable 5.1, veicot dažus sarežģītus uzdevumus.
“Claude Opus 5.5 ir mūsu pirmais laidiens, kopš aicinājām uzlabot robežu. Pirms izlaišanas to pārbaudīja ārēji vērtētāji, tostarp Frontier Design un METR. Mūsu automatizētajā uzvedības auditā, visplašākajā mūsu veiktajā saskaņošanas testā, Opus 5.5 ir mūsu līdz šim pārbaudītais modelis ar jaudīgāko veiktspēju. Tajā ir iekļauti arī vispiemērotākie modeļi, kas izstrādāti mūsu emuāra vislielākajiem drošības pasākumiem.
Anthropic palielina cenu un kodēšanas veiktspēju
Anthropic saka, ka programmatūras izstrādes etalonā Opus 5.5 ieguva augstākus rezultātus nekā OpenAI GPT-5.6 Sol, un tā palaišana šajā testā maksāja aptuveni vienu trešdaļu vairāk. Etalona rezultāti ne vienmēr ir tieši saistīti ar katru reālo darba slodzi, taču apgalvojums norāda uz to, kur virzās AI modeļu sacīkstes: veiktspēja uz vienu dolāru kļūst gandrīz tikpat svarīga kā neapstrādāta spēja.
Anthropic minētās agrīnās pārbaudes deva dažus pārsteidzošus rezultātus. Tiek ziņots, ka viens testētājs izmantoja Opus 5.5, lai pabeigtu 680 000 rindu koda migrāciju mazāk nekā vienas dienas laikā. Citā testā modelis veiksmīgi samazināja ielādes laiku katrā tīmekļa lietojumprogrammas lapā 39 no 40 mēģinājumiem. Anthropic teica, ka Opus 5 veica mazākus uzlabojumus un dažkārt mainīja lietojumprogrammas darbību.
Ekonomika varētu izrādīties tikpat nozīmīga. AI uzņēmumi ir pavadījuši vairākus gadus, cenšoties pēc lielākiem modeļiem un augstākiem kritērijiem. Uzņēmumi, kas izvieto aģentus un kodēšanas sistēmas, saskaras ar atšķirīgu aprēķinu. Modelis, kas var paveikt to pašu darbu, izmantojot mazāk aprēķinu, var radīt ievērojamus ietaupījumus, tiklīdz lietojums sasniedz miljardu marķieru.
Opus 5.5 ir pieejams Anthropic un lielākajās mākoņu platformās, tostarp Amazon Web Services, Google Cloud un Microsoft Azure. Uzņēmums palielina piecu stundu lietošanas ierobežojumus Pro, Max, Team un Enterprise abonentiem.
Pierobežas modelis tika izlaists saistībā ar aicinājumiem palēnināt robežu
Palaišana nes neparastu spriedzi. Anthropic izpilddirektors Dario Amodei šā mēneša sākumā aicināja globālo AI kopienu palēnināt jaunu iespēju izlaišanu, jo pieaug bažas par riskiem, ko rada arvien spējīgākas AI sistēmas.
Anthropic, izlaižot Opus 5.5, savā korpusā padara drošību par galveno.
Neatkarīgas AI drošības pētniecības grupas Frontier Design un METR novērtēja modeli pirms palaišanas. Anthropic saka, ka Opus 5.5 ir reģistrējis līdz šim spēcīgākos rezultātus savā automatizētajā uzvedības auditā, kas ietver tūkstošiem simulētu scenāriju, ko izmanto, lai pārbaudītu modeļa uzvedību un saskaņošanu.
Uzņēmums norādīja, ka Opus 5.5 ir par aptuveni 85% mazāka iespēja nekā Opus 5 vai Mythos 5.1 mēģināt apiet ierobežošanas robežas īpašā novērtējumā. Anthropic saka, ka modelis ir izturīgāks pret tūlītēju injekciju un mazāk ticams, ka viņš veiks darbības, kuras ir grūti mainīt, vai neatbilst norādījumiem, kas tam ir doti.
Šie rezultāti nāk no paša Anthropic testēšanas sistēmas, un tie ir jāuzskata par uzņēmuma ziņotiem konstatējumiem, nevis kā neatkarīgs pierādījums tam, ka modelis ir drošāks katrā izvietošanas reizē. Frontier Design un METR veiktā ārējā pārbaude pirms izlaišanas pievieno vēl vienu pārbaudes līmeni, sacīja Reuters.
Uzņēmums Anthropic piemēro aizsardzības pasākumus, kas ir līdzīgi tiem, kas izmantoti Claude Fable 5.1, atsaucoties uz salīdzināmām iespējām bioloģijā un kiberdrošībā. Pārbaudīti dzīvības zinātņu pētnieki var pieteikties plašākai piekļuvei, izmantojot uzņēmuma verifikācijas programmu, un tuvākajās nedēļās plānota paplašināta piekļuve pārbaudītiem kiberdrošības speciālistiem.
Uzņēmums saka, ka nākamie ir Claude Sonnet 5.5 un Claude Haiku 5.5, un abi modeļi ir gaidāmi tuvākajās nedēļās.
Opus 5,5 punkti par maiņu AI robežskrējienā. Lielākiem etalonskaitļiem joprojām ir nozīme, taču modeļu ražotāji tagad cīnās par to, ko klienti var izmērīt tieši savos rēķinos: cik daudz noderīga darba var nopirkt katrs aprēķinātais dolārs.
